


 Kundeservice +47 55 50 91 50


-
Produkter
Finn blant alle våre produkter
-
- PoE for DIN-montering
- Lær å teste nettverk
- Lær å teste nettverk
- Smart og praktisk
- Direktronik SFP – enklere og rimeligere
- Smartkeeper kabellås og portplugger
- Låsbart – for funksjonene du ikke vil gi slipp på
- Øk driftssikkerheten med en låsbar strømkabel
- Nu beger vi oss till Norge
- Rackstuds er fremtidens kassemutter
Andre måter å finne på
-
Andre måter å finne på
-
- Bredde på fiberkontakter, med eller uten trekkøye
- Smartkeeper kabellås og portplugger
- Låsbart – for funksjonene du ikke vil gi slipp på
- Kabeltrommelen, perfekt både akutt og midlertidig
- Øk driftssikkerheten med en låsbar strømkabel
- Velg riktig ladekabel til elbilen
- Hvordan fungerer en OTDR
- Velg din leverandør med omhu
- Produkter og løsninger
- Rackstuds er fremtidens kassemutter
- Nøyaktig og effektiv merking av kabler!
Andre måter å finne på
-
Andre måter å finne på
-
- Sørg for riktig temperatur ved kjøletransport
- Overvåkningskameraer
- Overvåkning av større områder.
- Overvåkningskameraer
- Ta drivhuset ditt til neste nivå
- Detaljhandel overvåking
- Overvåk temperaturen i butikken med Wi-Fi-sensorer
- Riktig luftkvalitet på arbeidsplassen
- Varsellamper i trafikken
- RFID-integrerte etiketter
- Overvåkings- og kontrollrom
- Overfylte søppeldunker er ikke lenger et problem
Andre måter å finne på
-
- Lær deg fjernundervisning, nettkurs og strømming av media
- Trådløs konferanseromsløsning
- Forbedret presentasjonsteknikk ved hjelp av teknologi for bedre presentasjoner
- AV over IP – strøm media via Ethernet
- Videovegger og digitale skilt
- Broadcasting – produksjon og bearbeiding med krav til båndbredde
- AV-presentasjon – profesjonell konferanseteknologi via fiber
- Fiberbåret AV – strømmende media via fiber
Andre måter å finne på
-
Andre måter å finne på
-
Andre måter å finne på
-
Andre måter å finne på
-
Andre måter å finne på
-
-
- ...
- Forside
- Kunnskapsbanken
- Maksimal fremkommelighet i nettverket
- Slik overlever nettverket en avgravd fiberforbindelse!
Maksimal fremkommelighet i nettverket
-
Nettverk

-
Koaksialkabel og kontakter
-
SFP for alle behov
-
Energisystemer og lading
-
Datasenter og serverhaller
-
IP-alarm og fjernkontroll
-
Testing og verifisering
-
Ergonomi og komfort
-
Maksimal fremkommelighet i nettverket
-
Tryggere miljøer
-
Kundetilpassede løsninger
-
IoT – Internet of Things
-
Tilbehør og grensesnitt
-
Merking og Etikettering
-
AV over IP
-
Strømforsyninger
-
Elektromekanikk
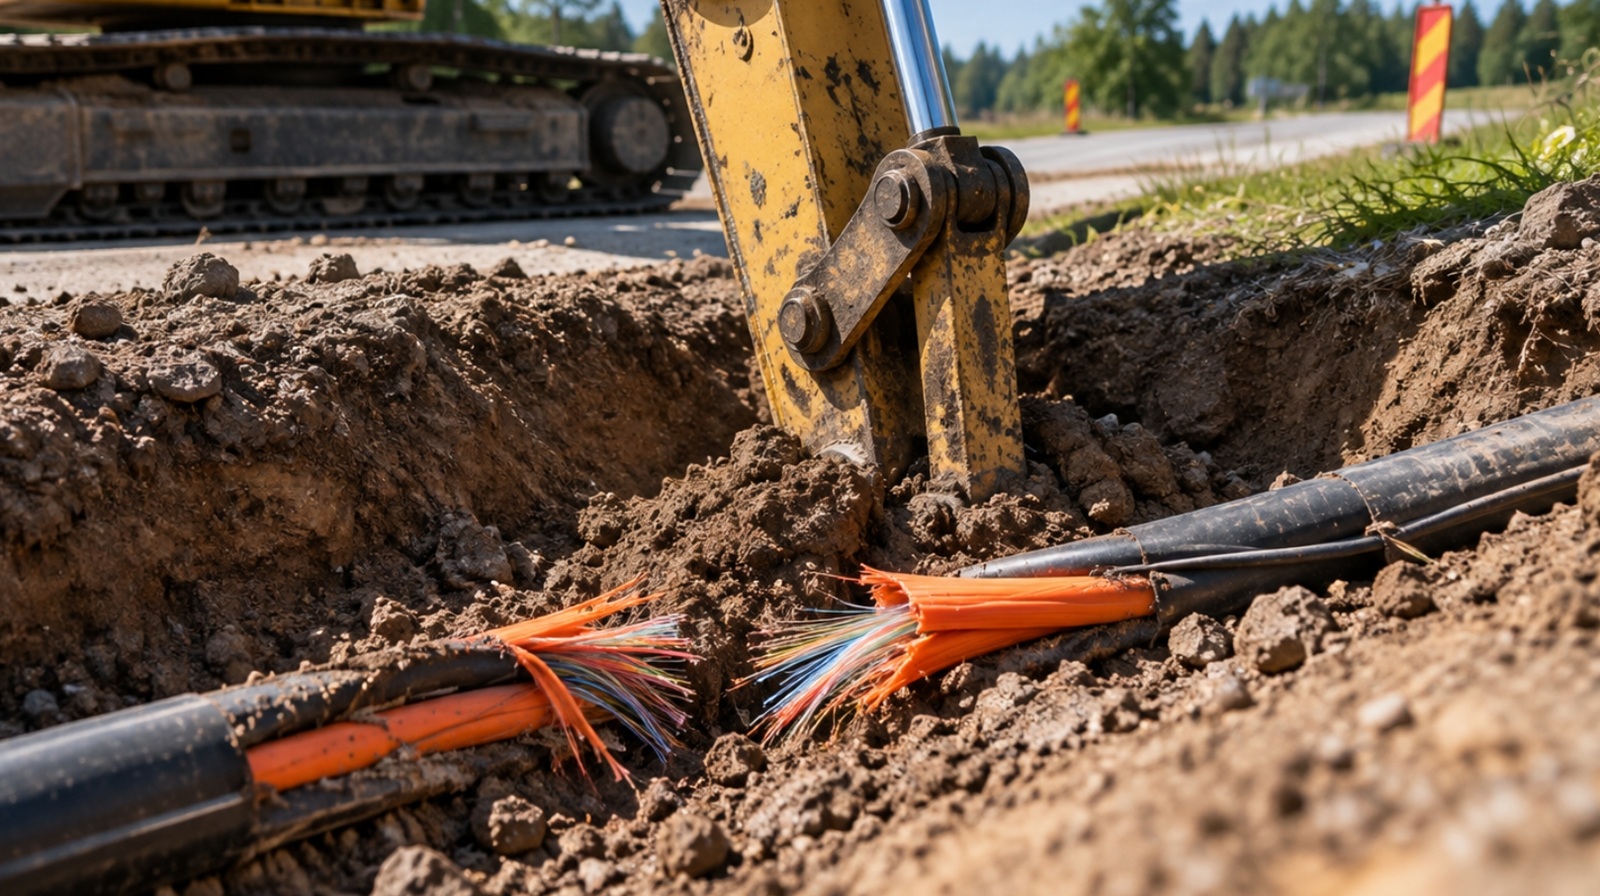
Slik overlever nettverket en avgravd fiberforbindelse!
I et robust Ethernet-nettverk er det ikke nok å ha en ekstra fiber. Nettverket må også kunne oppdage at den ordinære forbindelsen har forsvunnet, aktivere en reservevei uten å skape en nettverksloop og gjøre dette raskt nok til at brukere og programvare påvirkes minst mulig.
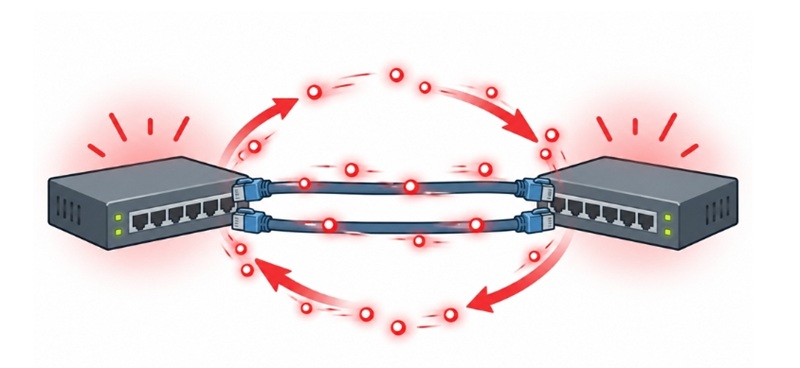
Doble forbindelser kan skape ødeleggende looper
Det er lett å tro at to kabler er bedre enn én mellom switchene. Da dobler man vel hastigheten og får en backup hvis den ene kobles fra eller går i stykker, ikke sant? Prøv, så får du se – men helst bare når du er alene på kontoret hvis du vil beholde jobben :-)
I praksis er dette ikke noen god idé. Du skaper nemlig en såkalt Layer 2-loop, noe som svært raskt kan bli katastrofalt fordi Ethernet-rammer kan sirkulere mellom switchenes porter i en endeløs loop. Dette kan raskt mette forbindelsene, belaste CPU-en i switchene og gjøre nettverket praktisk talt ubrukelig. Effekten er ikke begrenset til bare de to switchene som er koblet feil, men kan påvirke alle switcher og enheter innenfor samme Layer 2-domene, normalt samme VLAN. Enten det dreier seg om kobber- eller fiberkabel, gir doble forbindelser derfor ikke automatisk redundans.
(Unntaket er dersom forbindelsene bevisst konfigureres som én felles linkgruppe, for eksempel med LACP (link aggregation). Da behandles de som én logisk forbindelse og kan gi både redundans og høyere samlet kapasitet.)
Det er her teknologier som Spanning Tree, RSTP, MSTP og Ethernet Ring Protection Switching (ERPS) kommer inn i bildet.
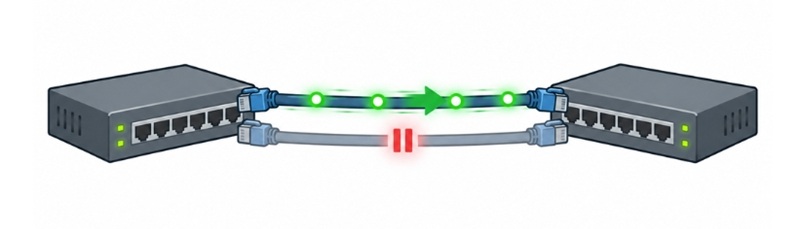
Reserveforbindelse uten loop
Ethernet er altså følsomt for looper. Broadcast- og multicasttrafikk kan begynne å sirkulere rundt i nettverket, MAC-tabeller kan bli ustabile og nettverket kan raskt bli overbelastet. Derfor må redundante Ethernet-nettverk normalt holde en del av reserveveien blokkert. Når en feil oppstår, aktiveres den alternative veien på en kontrollert måte.
Det er altså ikke den ekstra fiberen i seg selv som skaper redundansen. Det er kombinasjonen av en fysisk reservevei og en protokoll som styrer trafikken ved feil.
Spanning Tree – den generelle løsningen
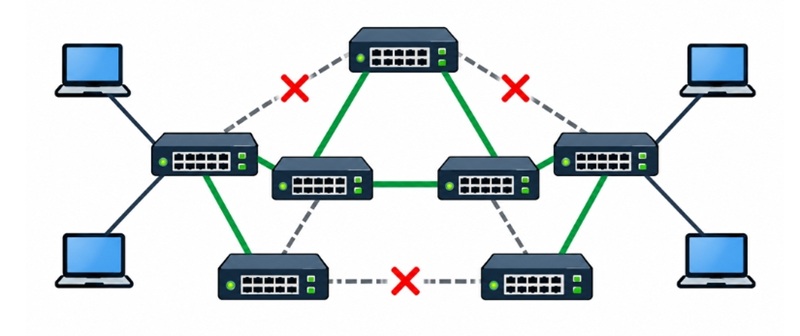
Spanning Tree ble utviklet for å gjøre det mulig å bygge Ethernet-nettverk med flere fysiske veier uten å skape looper. Switchene velger en logisk, loopfri topologi der enkelte forbindelser brukes mens andre holdes blokkert. Hvis en aktiv forbindelse går ned, kan nettverket beregne topologien på nytt og bruke en vei som tidligere var blokkert. I moderne nettverk brukes først og fremst RSTP (Rapid Spanning Tree Protocol) og MSTP (Multiple Spanning Tree Protocol).
Den store styrken til Spanning Tree er fleksibiliteten. Nettverket trenger ikke å være bygget som en ring, men kan ha mer komplekse topologier med mange redundante forbindelser. Samtidig innebærer denne fleksibiliteten at switchene må avgjøre hvordan den nye topologien skal se ut når en feil oppstår.
Hvor raskt dette skjer, er litt vanskeligere å gi et eksakt svar på, siden disse konfigurasjonene kan bygges mer komplekst. Generelt kan man si at klassisk Spanning Tree kan bruke flere titalls sekunder på å gjenopprette nettverket etter en feil. RSTP og MSTP er betydelig raskere og kan under gunstige forhold koble inn reserveforbindelsen på under ett sekund, men den faktiske tiden avhenger av feiltype, topologi og implementasjon.
Cisco skriver for eksempel: "The RSTP takes advantage of point-to-point wiring and provides rapid convergence of the spanning tree. Reconfiguration of the spanning tree can occur in less than 1 second (in contrast to 50 seconds with the default settings in the IEEE 802.1D spanning tree)." i sin "Layer 2 Configuration Guide" for Catalyst 9300-serien.
Juniper skriver på sin side: "Where STP took up to 50 seconds to respond to topology changes, RSTP responds to changes within the timeframe of three hello BPDUs (bridge protocol data units), or 6 seconds." i sin Spanning-Tree Protocols User Guide fra 2025.
ERPS – når nettverket er bygget som en ring
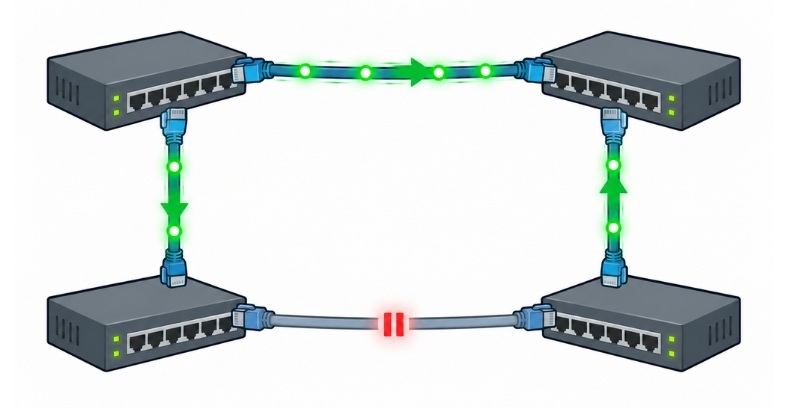
Når nettverket bevisst bygges som en ring, finnes det en mer spesialisert løsning: Ethernet Ring Protection Switching, ERPS, i henhold til ITU-T G.8032. ERPS tar utgangspunkt i at nettverket allerede har en kjent ringtopologi. En del av ringen holdes normalt blokkert for å forhindre looper.
Anta for eksempel at nettverket består av fire svitsjer som er koblet i en ring på denne måten:
A — B — C — D — A
Hvis forbindelsen mellom D og A normalt er blokkert, går trafikken fra A til D via B og C.
Hvis fiberen mellom B og C graves av, oppdager switchene feilen, og ERPS åpner den tidligere blokkerte forbindelsen mellom A og D. Trafikken kan da gå:
B → A → D → C
Nettverket har gått fra en lukket ring til en åpen ring, men kommunikasjonen kan fortsette.
Dette er et eksempel på det som noen ganger kalles deterministisk Layer 2-redundans. Nettverket vet allerede hvordan ringtopologien ser ut, hvilken vei som normalt er blokkert, og hvordan trafikken skal omdirigeres når en feil oppstår.
Hva skjer egentlig når fiberen ryker?
Fra selve kabelbruddet til kommunikasjonen er gjenopprettet, må flere ting skje. Først må feilen oppdages. Det kan skje ved at den fysiske linken går ned. Deretter må switchene informeres om topologiendringen. I ERPS brukes R-APS, Ring Automatic Protection Switching, for å koordinere dette.
Deretter må den alternative veien åpnes samtidig som nettverket sørger for at det ikke oppstår noen loop. Til slutt kan switchenes MAC-tabeller måtte oppdateres. Hvis en MAC-adresse tidligere ble nådd via én port, men etter fiberbruddet befinner seg i motsatt retning, må switchene raskt oppdatere sine "adresselister".
Det er summen av disse trinnene som avgjør den faktiske gjenopprettingstiden.
Hvorfor snakkes det om 50 millisekunder?
ERPS forbindes ofte med svært rask omkobling til reserveforbindelsen. G.8032 er utviklet for å kunne gi gjenopprettingstider rundt eller under 50 millisekunder under optimale forhold (færre enn 16 ringnoder og en fiberomkrets på under 1200 km). Det betyr imidlertid ikke at ethvert produkt merket med "ERPS support" automatisk garanterer samme resultat i alle nettverk.
Den faktiske tiden påvirkes blant annet av hvor raskt feilen oppdages, hvor mange noder som finnes i ringen, og hvor raskt MAC-tabellene kan oppdateres. Derfor bør man skille mellom støtte for protokollen og verifisert failover-ytelse. I nettverk der kort avbruddstid er viktig, bør systemet derfor testes i praksis: trekk ut fiberen eller bryt strømmen til en node, og mål hvor lenge trafikken faktisk forstyrres.
ERPS eller Spanning Tree?
Det ene er ikke generelt bedre enn det andre. Spanning Tree passer godt når nettverket har en generell Layer 2-topologi med flere redundante veier. ERPS passer spesielt godt når nettverket bevisst bygges som en ring og man ønsker en rask og forutsigbar beskyttelsesmekanisme.
Spanning Trees styrke er altså fleksibiliteten, mens styrken til ERPS er spesialiseringen på ringtopologier. Det er også fullt mulig å bruke teknologiene i ulike deler av samme nettverk.
Krever ERPS en kraftigere switch?
Ikke nødvendigvis. Når nettverket fungerer normalt, switcher brukertrafikken fortsatt gjennom switchens forwarding-maskinvare. Selve ERPS-protokollen trenger ikke å innebære noen stor, kontinuerlig prosessorbelastning. Det som kan stille høyere krav, er den raske feilhåndteringen. Switchen må kunne oppdage feil, endre forwarding-state og oppdatere relevante tabeller svært raskt. Av den grunn kan to switcher som begge støtter G.8032, prestere forskjellig ved en faktisk feil.
ERPS finnes derfor ofte i produkter som er utviklet for bynett, industri, energi, transport og andre miljøer der høy tilgjengelighet er viktig. Det betyr ikke nødvendigvis at ERPS i seg selv krever dyr maskinvare, men snarere at produktet er bygget og testet for denne typen bruk.
Den fysiske føringsveien er minst like viktig
Ingen redundansmekanisme kan kompensere for en dårlig bygget fiberinfrastruktur. To fiberforbindelser kan se redundante ut i nettverksdiagrammet, men likevel ligge i samme kabel eller samme kabelrør. Én enkelt graveskade kan da kutte begge forbindelsene samtidig.
Reell redundans krever derfor at man ser på hele kjeden: switchporter, optiske moduler, patching, fiberkabler, kanalisation, strømforsyning og nodene trafikken passerer gjennom. Også kapasiteten på reserveveien må være tilstrekkelig. Hvis all trafikk normalt er fordelt over flere forbindelser, må den gjenværende veien kunne håndtere belastningen når en feil oppstår.
Til syvende og sist handler et robust nettverk ikke om å forhindre alle feil. Fiber vil bli gravd av, optiske moduler vil gå i stykker, og switcher vil av og til miste strømmen. Målet er i stedet å gjøre konsekvensene av en feil så små, kortvarige og forutsigbare som mulig.
Ta kontakt med oss hvis du vil diskutere redundans og fremkommelighet i nettverket. Vi er enkle å nå og svarer direkte på chat, e-post eller telefon: +47 55 50 91 50
Gå heller ikke glipp av artiklene i Kunnskapsbanken, abonner på nyhetsbrevet
© Copyright 2026-10-05, innholdet er beskyttet i henhold til opphavsrettsloven.

Relevante produkter


